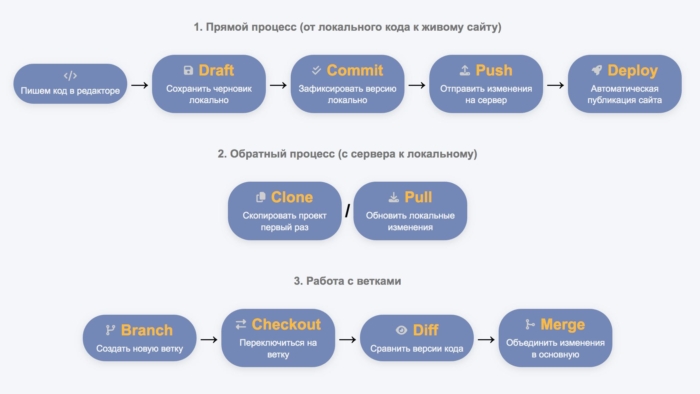
Lorsque tu commences à travailler avec Git, tous ces nouveaux mots — commit, push, pull, branch, merge — peuvent être déroutants et effrayants. Tu es habitué à écrire simplement du code, à enregistrer le fichier et à le copier manuellement sur le serveur, et maintenant il y a tout à coup plus de dix commandes et concepts.
Pour faciliter la mémorisation et la compréhension, nous avons divisé tout le processus Git en trois chaînes logiques :
- Processus direct — comment ton code passe de l’ordinateur local au site en direct.
- Processus inverse — comment télécharger le code du serveur vers chez soi.
-
Travailler avec des branches — comment expérimenter en toute sécurité avec de nouvelles fonctionnalités.
Ci-dessous se trouve une visualisation interactive. Cliquez sur le nom/l’icône — vous accéderez à une explication détaillée. Cliquez sur le texte sous l’icône — une brève astuce apparaîtra.
Enregistrer le brouillon localement
Enregistrer la version localement
git add . + git commit -m "message"Enregistrement des modifications en tant que nouvelle version.
Envoyer la version sur le serveur
git push origin branchEnvoi des commits vers le dépôt distant.
Publication de la version du code
Copier le projet pour la première fois
git clone https://...Copie complète du dépôt avec l’historique.
Pull
Mettre à jour les modifications locales
git pullTéléchargement et fusion des dernières modifications depuis le serveur.
Créer une nouvelle branche
git branch feature ou git checkout -b feature
Changer de branche
git checkout ou git switch branch
Comparer les versions du code
git diffVisualiser les modifications entre les versions.
Fusionner les modifications dans la branche principale
git merge feature-branchFusion de la branche prête dans main/master.
1. Processus direct : de l’écriture du code au site en direct
C’est la chaîne principale que tu utiliseras le plus souvent. Avant, tu écrivais du code → sauvegardais → copiais manuellement sur le serveur. Maintenant, Git le fait de manière plus intelligente et plus sûre.
- Écriture du code
Travail habituel dans l’éditeur (VS Code, Notepad++ etc.). Rien de nouveau — tu écris simplement du PHP, HTML, JS ou ce que tu as. - Draft (brouillon)
C’est un commit intermédiaire, lorsque tu veux rapidement sauvegarder l’état actuel, mais qu’il n’est pas encore prêt.
Exemple : «Sauvegarder le brouillon localement».
Analogie : avant, tu pouvais sauvegarder le fichier sous index_temp.php. Maintenant, tu fais simplement un commit avec le message «WIP : j’essaie un nouveau design». - Commit (sauvegarder la version localement)
Étape principale de l’enregistrement des modifications. Tu dis à Git : «Voici un morceau de travail prêt, enregistre-le comme version».
Analogie : avant, un gros changement — un nouveau fichier index_2.0.php. Maintenant, un fichier + l’historique de toutes les versions dans Git. - Push (envoyer la version sur le serveur)
Envoi de tous tes commits locaux vers le dépôt distant.
Analogie : avant, tu téléchargeais manuellement des fichiers par FTP/SSH. Maintenant, avec une seule commande, tout part sur le serveur. - Deploy (publication de la version du code)
Moment où le code devient un site web vivant. Sur des hébergements partagés comme Beget, cela se fait automatiquement après le push grâce à un hook.
Analogie : avant, les fichiers apparaissaient sur le site immédiatement après la copie.
2. Processus inverse : du serveur à l’ordinateur local
Lorsque tu dois continuer à travailler sur un autre appareil ou mettre à jour le code après des modifications d’autres.
- Clone (copier le projet pour la première fois)
Copie complète de tout le dépôt du serveur vers ton ordinateur. À faire une fois au début du projet.
Analogie : télécharger tout le site par FTP dans un nouveau dossier. - Pull (mettre à jour les modifications locales)
Téléchargement des dernières modifications du serveur + fusion automatique avec ton code.
Analogie : télécharger manuellement les fichiers mis à jour du serveur et remplacer les tiens.
3. Travailler avec des branches : des expériences sûres
Les branches sont le super pouvoir de Git. Elles permettent de travailler sur de nouvelles fonctionnalités sans casser le code principal.
- Branch (créer une nouvelle branche)
Tu crées une ligne de développement distincte.
Analogie : avant, tu pouvais copier tout le projet dans un autre dossier pour des expériences. Une branche — c’est la même chose, mais sans duplication de fichiers. - Checkout (changer de branche)
Passer à une autre branche pour y travailler.
Analogie : ouvrir un autre dossier avec du code. - Diff (comparer les versions du code)
Visualiser les différences entre les versions/branches. Git montre ce qui a été ajouté, supprimé, modifié.
Analogie : comparer manuellement deux fichiers. - Merge (fusionner les modifications dans la branche principale)
Fusion de la branche prête dans la branche principale (généralement main ou master).
Analogie : copier manuellement les modifications réussies du dossier de test dans la branche principale.
Conclusion
Ces trois chaînes couvrent 90 % de ce dont tu as besoin au départ. Commence par le processus direct — configure Git sur Beget, et déjà dans un jour, tu pourras pousser des modifications d’un simple clic au lieu de le faire manuellement par FTP. Avec le temps, les branches deviendront ton meilleur ami — plus de index_old.php et index_new_test.php !
Garde cette page comme une feuille de triche. Une fois que tu es à l’aise, passe à des choses plus complexes comme rebase ou pull request.